Snapshot của graykode/ALBERT-Pytorch: 228★ · Python · AI Tools. Pytorch Implementation of ALBERT(A Lite BERT for Self-supervised Learning of Language Representations)
Tóm tắt dựng từ metadata GitHub của chính dự án — chưa có bài review TopGit. Trang sẽ tự động cập nhật khi bài review đầy đủ được xuất bản.
VÌ SAO CHƯA CÓ REVIEW
TopGit viết bài đầy đủ cho repo có nhiều sao nhất và được yêu cầu nhiều nhất. Trang này là snapshot trong thời gian chờ — xem README gốc ở tab READ ME.
Simply implementation of ALBERT(A LITE BERT FOR SELF-SUPERVISED LEARNING OF LANGUAGE REPRESENTATIONS) in Pytorch. This implementation is based on clean dhlee347/pytorchic-bert code.
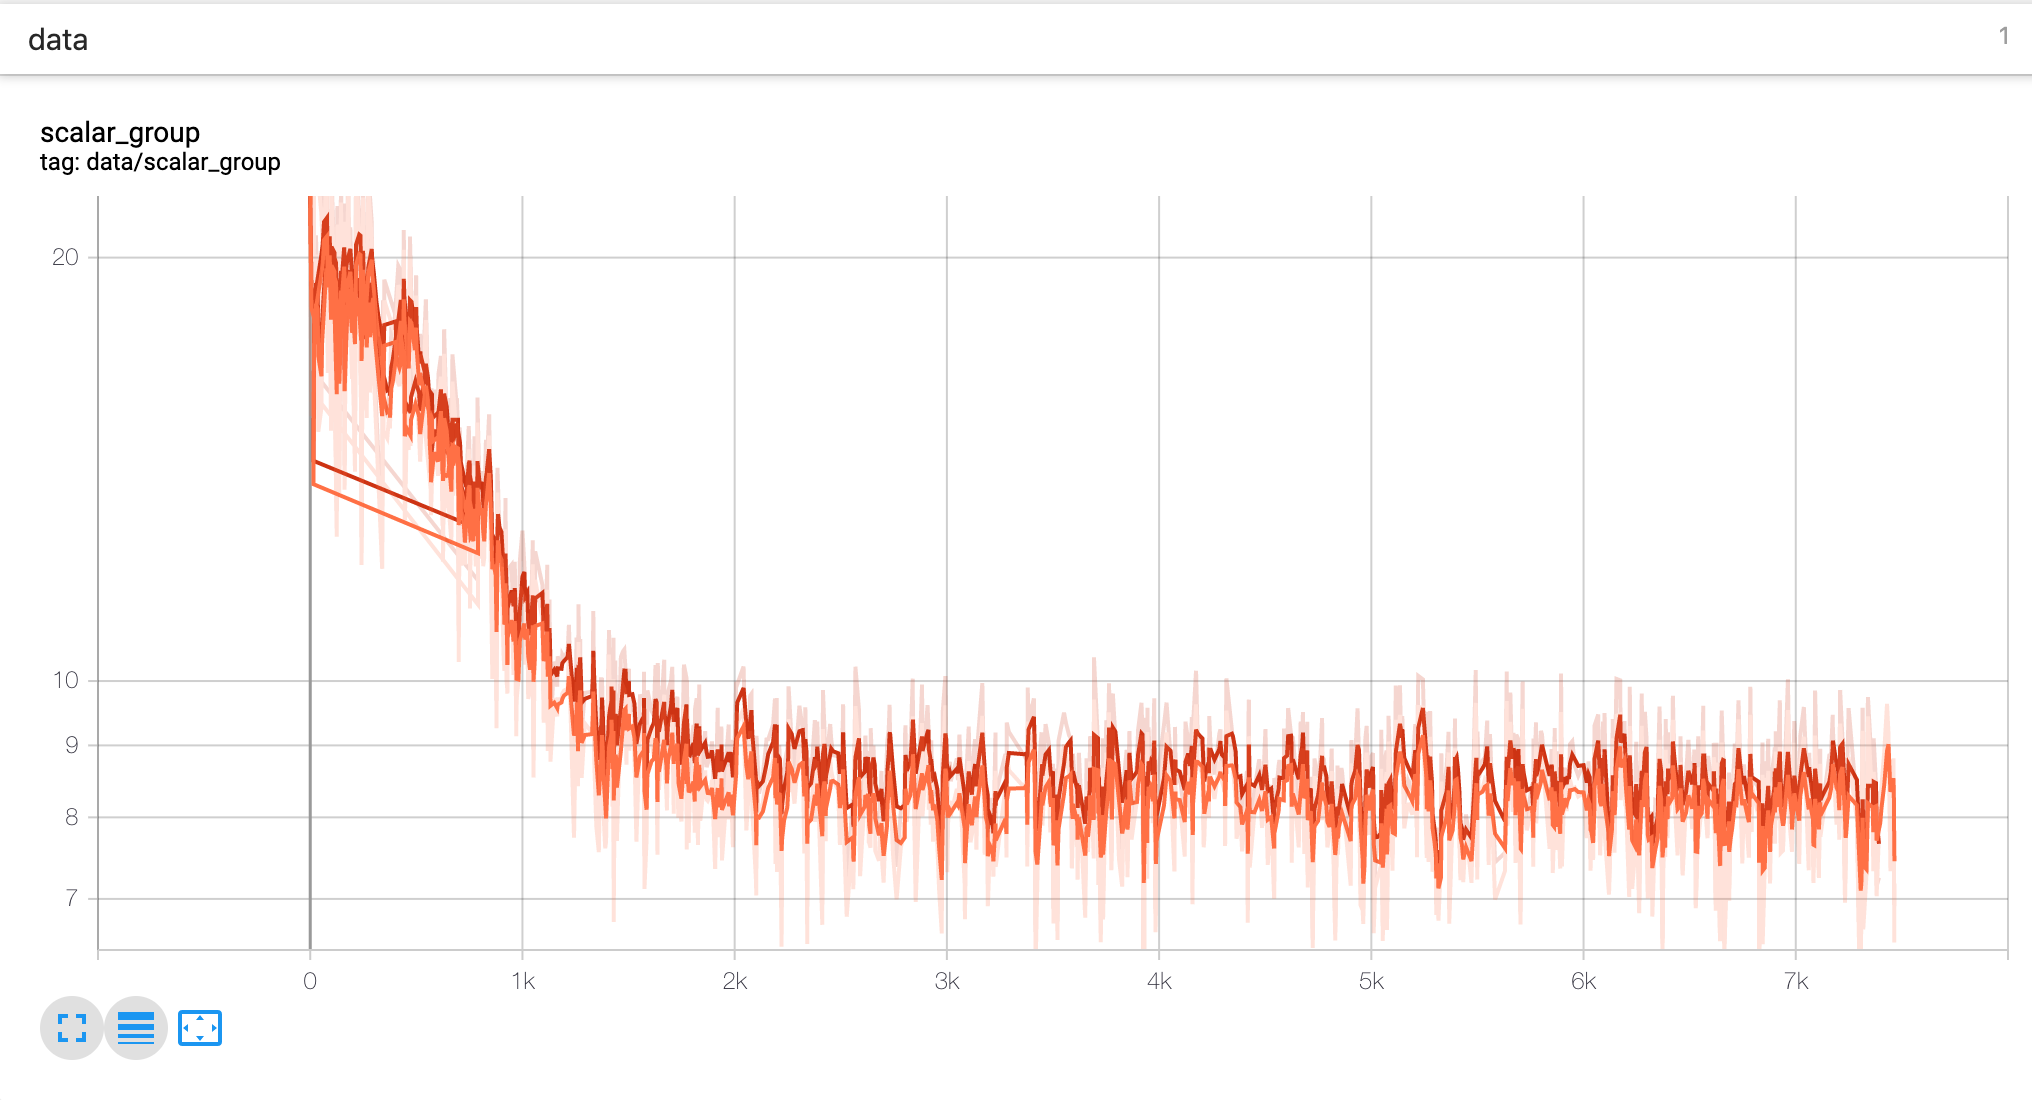
Please make sure that I haven't checked the performance yet(i.e Fine-Tuning), only see SOP(sentence-order prediction) and MLM(Masked Langauge model with n-gram) loss falling.
You can see my implementation of differnt between Original BERT and ALBERT
CAUTION Fine-Tuning Tasks not yet!
File Overview
This contains 9 python files.
tokenization.py : Tokenizers adopted from the original Google BERT's code
models.py : Model classes for a general transformer
optim.py : A custom optimizer (BertAdam class) adopted from Hugging Face's code
train.py : A helper class for training and evaluation
utils.py : Several utility functions
pretrain.py : An example code for pre-training transformer
PreTraining
With WikiText 2 Dataset to try Unit-Test on GPU(t2.xlarge). You can also use parallel Multi-GPU or CPU.
$ CUDA_LAUNCH_BLOCKING=1 python pretrain.py \
            --data_file './data/wiki.train.tokens' \
            --vocab './data/vocab.txt' \
            --train_cfg './config/pretrain.json' \
            --model_cfg './config/albert_unittest.json' \
            --max_pred 75 --mask_prob 0.15 \
            --mask_alpha 4 --mask_beta 1 --max_gram 3 \
            --save_dir './saved' \
            --log_dir './logs'

cuda (1 GPUs)
Iter (loss=19.162): : 526it [02:25,  3.58it/s]
Epoch 1/25 : Average Loss 18.643
Iter (loss=12.589): : 524it [02:24,  3.63it/s]
Epoch 2/25 : Average Loss 13.650
Iter (loss=9.610): : 523it [02:24,  3.62it/s]
Epoch 3/25 : Average Loss 9.944
Iter (loss=10.612): : 525it [02:24,  3.60it/s]
Epoch 4/25 : Average Loss 9.018
Iter (loss=9.547): : 527it [02:25,  3.66it/s]
...
SOP(sentence-order prediction) loss : In Original BERT, creating is-not-next(negative) two sentences with randomly picking, however ALBERT use negative examples the same two consecutive segments but with their order swapped.
is_next = rand() < 0.5 # whether token_b is next to token_a or not

tokens_a = self.read_tokens(self.f_pos, len_tokens, True)
seek_random_offset(self.f_neg)
#f_next = self.f_pos if is_next else self.f_neg
f_next = self.f_pos # `f_next` should be next point
tokens_b = self.read_tokens(f_next, len_tokens, False)

if tokens_a is None or tokens_b is None: # end of file
self.f_pos.seek(0, 0) # reset file pointer
return

# SOP, sentence-order prediction
instance = (is_next, tokens_a, tokens_b) if is_next \
else (is_next, tokens_b, tokens_a)
Cross-Layer Parameter Sharing : ALBERT use cross-layer parameter sharing in Attention and FFN(FeedForward Network) to reduce number of parameter.
class Transformer(nn.Module):
    """ Transformer with Self-Attentive Blocks"""
    def __init__(self, cfg):
        super().__init__()
        self.embed = Embeddings(cfg)
        # Original BERT not used parameter-sharing strategies
        # self.blocks = nn.ModuleList([Block(cfg) for _ in range(cfg.n_layers)])

        # To used parameter-sharing strategies
        self.n_layers = cfg.n_layers
        self.attn = MultiHeadedSelfAttention(cfg)
        self.proj = nn.Linear(cfg.hidden, cfg.hidden)
        self.norm1 = LayerNorm(cfg)
        self.pwff = PositionWiseFeedForward(cfg)
        self.norm2 = LayerNorm(cfg)
        # self.drop = nn.Dropout(cfg.p_drop_hidden)

    def forward(self, x, seg, mask):
        h = self.embed(x, seg)

        for _ in range(self.n_layers):
            # h = block(h, mask)
            h = self.attn(h, mask)
            h = self.norm1(h + self.proj(h))
            h = self.norm2(h + self.pwff(h))

        return h
Factorized Embedding Parameterziation : ALBERT seperated Embedding matrix(VxD) to VxE and ExD.
class Embeddings(nn.Module):
    "The embedding module from word, position and token_type embeddings."
 def __init__(self, cfg):
        super().__init__()
        # Original BERT Embedding
        # self.tok_embed = nn.Embedding(cfg.vocab_size, cfg.hidden) # token embedding

        # factorized embedding
        self.tok_embed1 = nn.Embedding(cfg.vocab_size, cfg.embedding)
        self.tok_embed2 = nn.Linear(cfg.embedding, cfg.hidden)

        self.pos_embed = nn.Embedding(cfg.max_len, cfg.hidden) # position embedding
        self.seg_embed = nn.Embedding(cfg.n_segments, cfg.hidden) # segment(token type) embedding
n-gram MLM : MLM targets using n-gram masking (Joshi et al., 2019). Same as Paper, I use 3-gram. Code Reference from XLNET implementation.
Cannot Implemente now
In Paper, They use a batch size of 4096 LAMB optimizer with learning rate 0.00176 (You et al., 2019), train all model in 125,000 steps.
graykode/ALBERT-Pytorch thuộc nhóm AI Tools trên TopGit, cùng 3 topic GitHub. Trang Trending và Topics liệt kê các repo cùng số sao và cùng ngôn ngữ để so sánh.
Đọc thêm về graykode/ALBERT-Pytorch ở đâu?
Trang TopGit này là một snapshot — tab "Readme" hiển thị nguyên văn README của repo (đã bỏ link, giữ ảnh). Repo GitHub ở github.com/graykode/ALBERT-Pytorch là nguồn chính thức.
graykode/ALBERT-Pytorch có bao nhiêu sao?
graykode/ALBERT-Pytorch có 228 sao GitHub — tải lại trang để xem số mới nhất, hoặc xem trực tiếp github.com/graykode/ALBERT-Pytorch. TopGit phản chiếu số sao của GitHub nhưng không cam kết đến từng phút.
graykode/ALBERT-Pytorch có những chủ đề gì?
GitHub topics của graykode/ALBERT-Pytorch: "albert", "bert", "pytorch". TopGit xếp repo vào nhóm AI Tools.
graykode/ALBERT-Pytorch còn đang phát triển không?
Commit gần nhất trên graykode/ALBERT-Pytorch là 5.6 năm trước (theo timestamp GitHub). Repo có 52 fork — một chỉ báo về mức độ quan tâm của cộng đồng.
graykode/ALBERT-Pytorch viết bằng ngôn ngữ gì?
graykode/ALBERT-Pytorch chủ yếu viết bằng Python. Trường "language" của GitHub dựa trên phần lớn byte ở nhánh mặc định.
Vì sao graykode/ALBERT-Pytorch được xếp vào nhóm AI Tools?
TopGit xếp graykode/ALBERT-Pytorch vào nhóm AI Tools dựa trên GitHub topics và mô tả của repo (gắn thẻ: "albert", "bert", "pytorch"). Việc phân loại dựa trên metadata thật của repo, không phải đoán theo cảm tính biên tập.
Đọc đầy đủ README ở tab phía trên.
Chưa chắc ALBERT-Pytorch có hợp với bạn?
Để ChatGPT, Claude hoặc Perplexity tìm hiểu giúp — bấm bên dưới và xem AI nói gì về ALBERT-Pytorch.
 /ALBERT-Pytorch